✉️ oi@planejamento.marketing

A análise de conteúdo no Instagram começa pela comparação justa: registre o objetivo de cada post, separe orgânico e pago e use a mesma janela de medição. Muitos perfis olham apenas os posts que “foram bem” e tentam repetir o que parecem ter em comum, misturando conteúdos publicados em dias diferentes e medidos em momentos distintos.
Uma análise de conteúdo para aprendizagem editorial faz o contrário: define antes o que será registrado, mede todos os posts do mesmo jeito e aceita que alguns resultados não permitem conclusão. Este artigo descreve um método para isso. O artigo complementar sobre LinkedIn trata do passo seguinte, que é ligar métricas de conteúdo a decisões de negócio em mais de um canal.
Análise de conteúdo no Instagram: compare na mesma janela
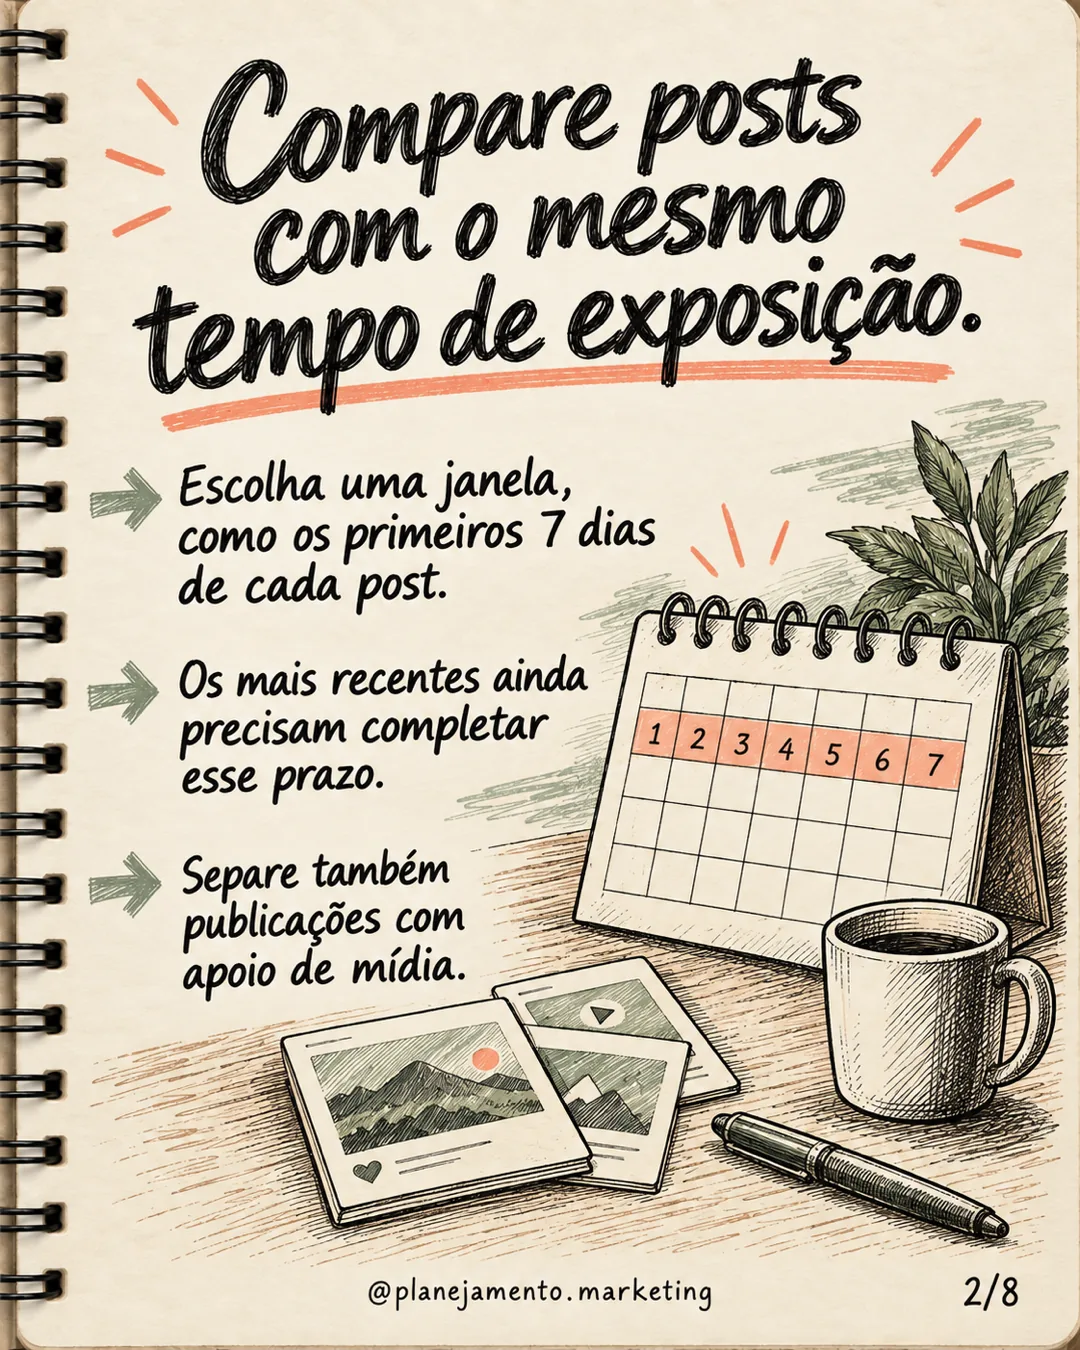
Um post publicado há dois meses acumulou alcance, salvamentos e compartilhamentos por muito mais tempo do que um publicado ontem. Comparar os totais atuais dos dois favorece o mais antigo sem dizer nada sobre qualidade. Por isso, escolha uma janela fixa, por exemplo os primeiros 7 dias após a publicação, e leia todos os posts nela.
Há também um motivo técnico. A documentação de insights de mídia da Meta informa que os dados usados no cálculo das métricas podem sofrer atraso de até 48 horas. Se você coleta o número no dia 7 exato, vale esperar uns dias a mais antes de congelar a planilha, e registrar a data da coleta.
Mídia paga fica separada
Parte das métricas do Instagram é calculada só com interações orgânicas, e outra parte inclui o que veio de anúncios. A mesma documentação diz que comentários, curtidas, visualizações e total de interações reportam apenas interações orgânicas, e que interações em anúncios com mídia não entram nesses números. Já os totais agregados (total de curtidas, comentários e visualizações) incluem engajamento de mídia promovida.
Na prática: se um post recebeu impulsionamento, o alcance e as interações dele não respondem mais à pergunta “o que o conteúdo fez sozinho”. Registre cada post com uma coluna “teve mídia paga: sim/não” e analise os dois grupos separadamente. Se o volume de posts for pequeno, é melhor deixar os impulsionados fora da comparação editorial.
O que registrar em cada post
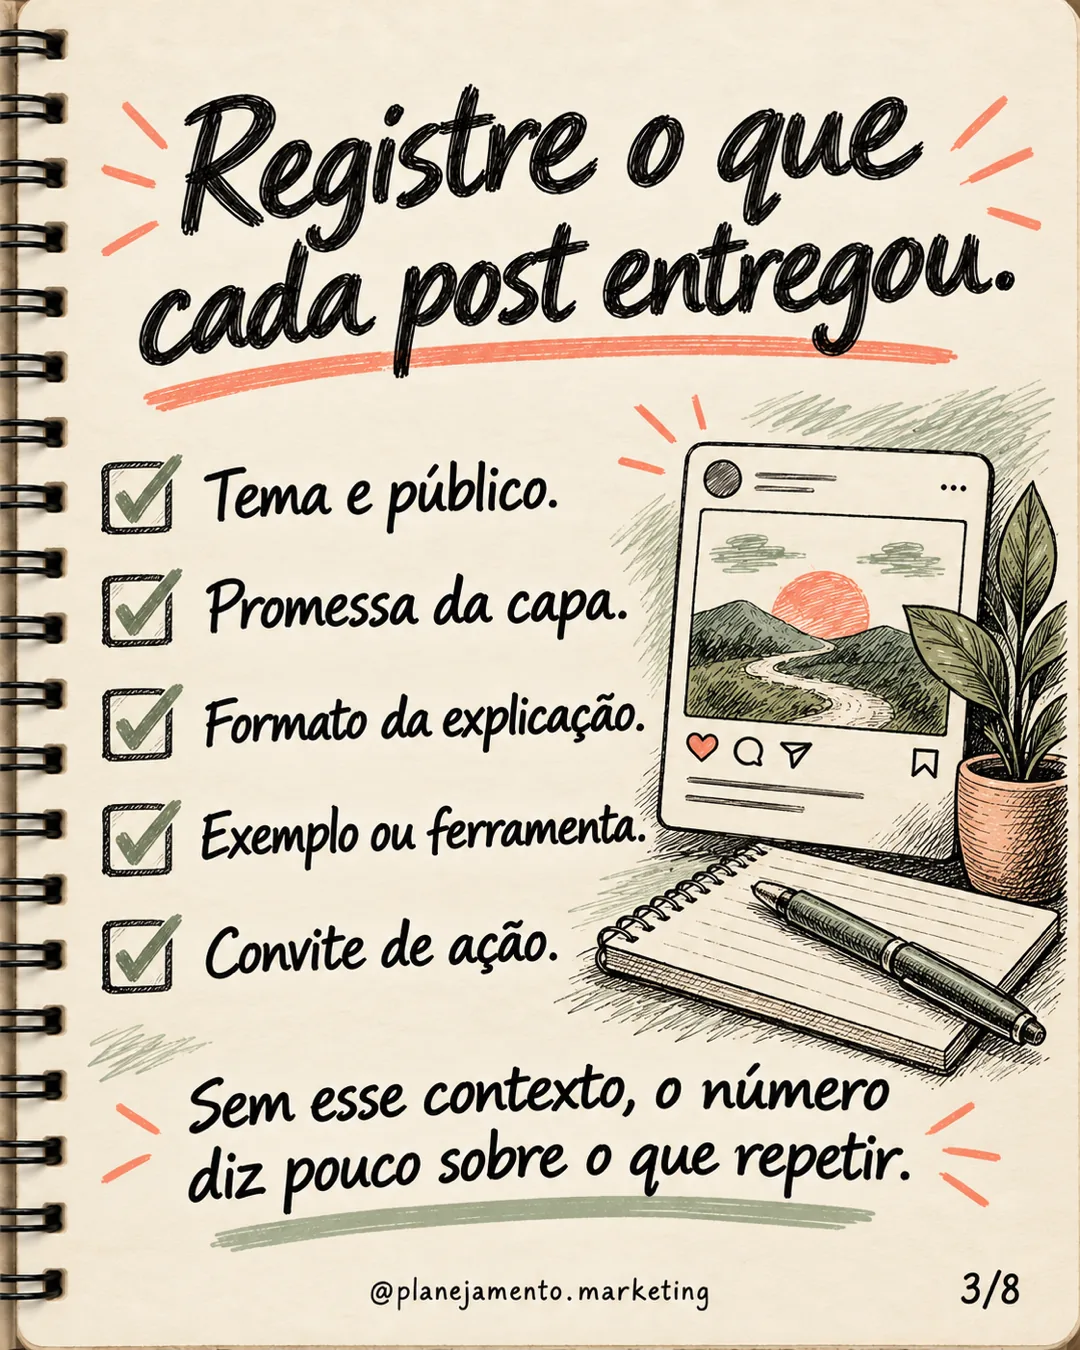
O registro precisa ter duas partes: o que o post era e o que aconteceu com ele.
Descrição do conteúdo (a ficha de codificação):
- Tema: o assunto, em uma lista fechada que você define antes (por exemplo: precificação, rotina de trabalho, erros comuns, bastidores).
- Público pretendido: para quem o post foi escrito (por exemplo: quem está começando, quem já vende, contratante).
- Promessa: o que o leitor ganha se ler ou salvar, em uma frase.
- Formato: carrossel, Reels, imagem única, vídeo curto, Stories.
- Exemplo: se o post usou um exemplo concreto, de que tipo (caso real, caso hipotético, número, nenhum).
- CTA: o que o post pede, ou “nenhum”.
Resultado, coletado na janela de 7 dias: alcance, salvamentos, compartilhamentos, comentários, curtidas, e a data da coleta.
A ficha só serve se duas pessoas (ou você, em dois dias diferentes) classificarem o mesmo post do mesmo modo. Hallgren, em um tutorial sobre confiabilidade entre avaliadores, lembra que a porcentagem simples de concordância não corrige a concordância esperada ao acaso e, por isso, superestima o acordo; o tutorial apresenta o kappa de Cohen como alternativa para variáveis categóricas. Na prática, classifique 20 posts duas vezes com intervalo de alguns dias e veja em quais campos você mudou de opinião: são as categorias mal definidas, que precisam de ajuste antes de qualquer conclusão.
Como ler salvamentos e compartilhamentos por alcance
Para comparar posts de tamanhos diferentes, divide-se a contagem pelo alcance:
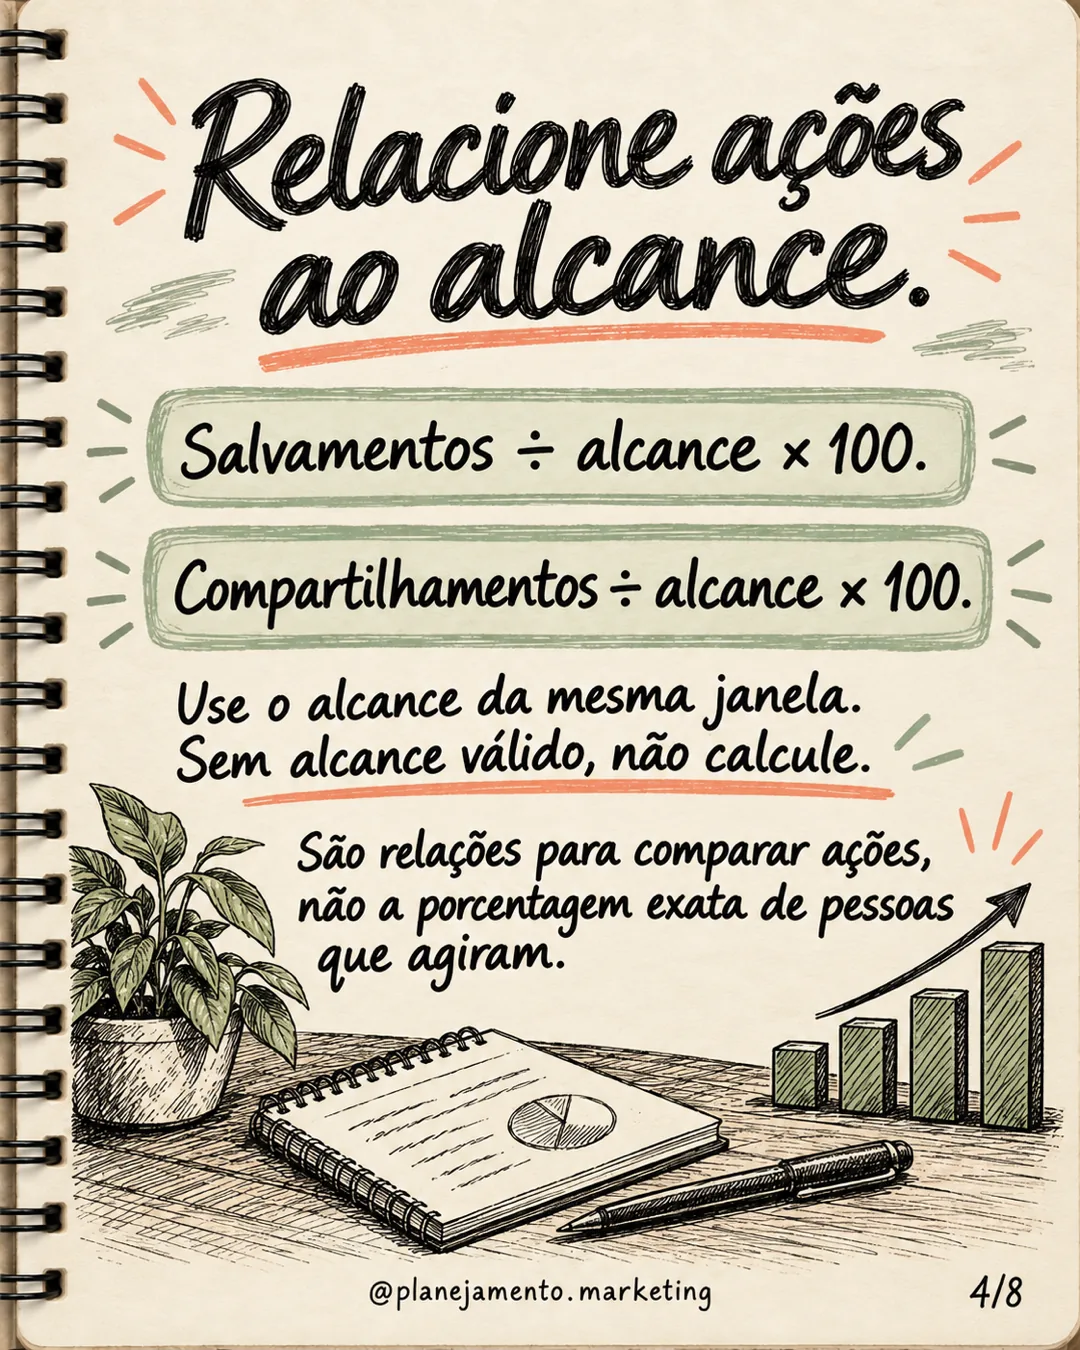
- Taxa de salvamento = salvamentos ÷ alcance × 100
- Taxa de compartilhamento = compartilhamentos ÷ alcance × 100
Três cuidados sobre o que esses números significam.
Primeiro, são razões entre duas contagens, e não o percentual exato de pessoas que salvaram ou compartilharam. A Meta define alcance como o número de contas únicas que viram a mídia pelo menos uma vez e marca a métrica como estimada. Já os salvamentos são contados como ocorrências de salvamento. Uma mesma conta pode, em tese, gerar mais de uma ocorrência, e o numerador e o denominador não têm a mesma natureza. Leia “2%” como “2 salvamentos para cada 100 contas alcançadas”, e não como “2% das pessoas”.
Segundo, salvar ou compartilhar não prova que a pessoa usou o conteúdo. É um sinal de interesse ou de intenção de voltar, e só isso.
Terceiro, se o alcance for zero, a razão não existe. Além disso, a API da Meta devolve um conjunto vazio, e não zero, quando o dado não existe ou está indisponível. Trate “vazio” e “zero” como casos diferentes na planilha: um é dado ausente, o outro é um resultado medido.
Exemplo hipotético (números fictícios)
Este exemplo é inventado, serve só para mostrar o cálculo e não representa nenhuma conta real.
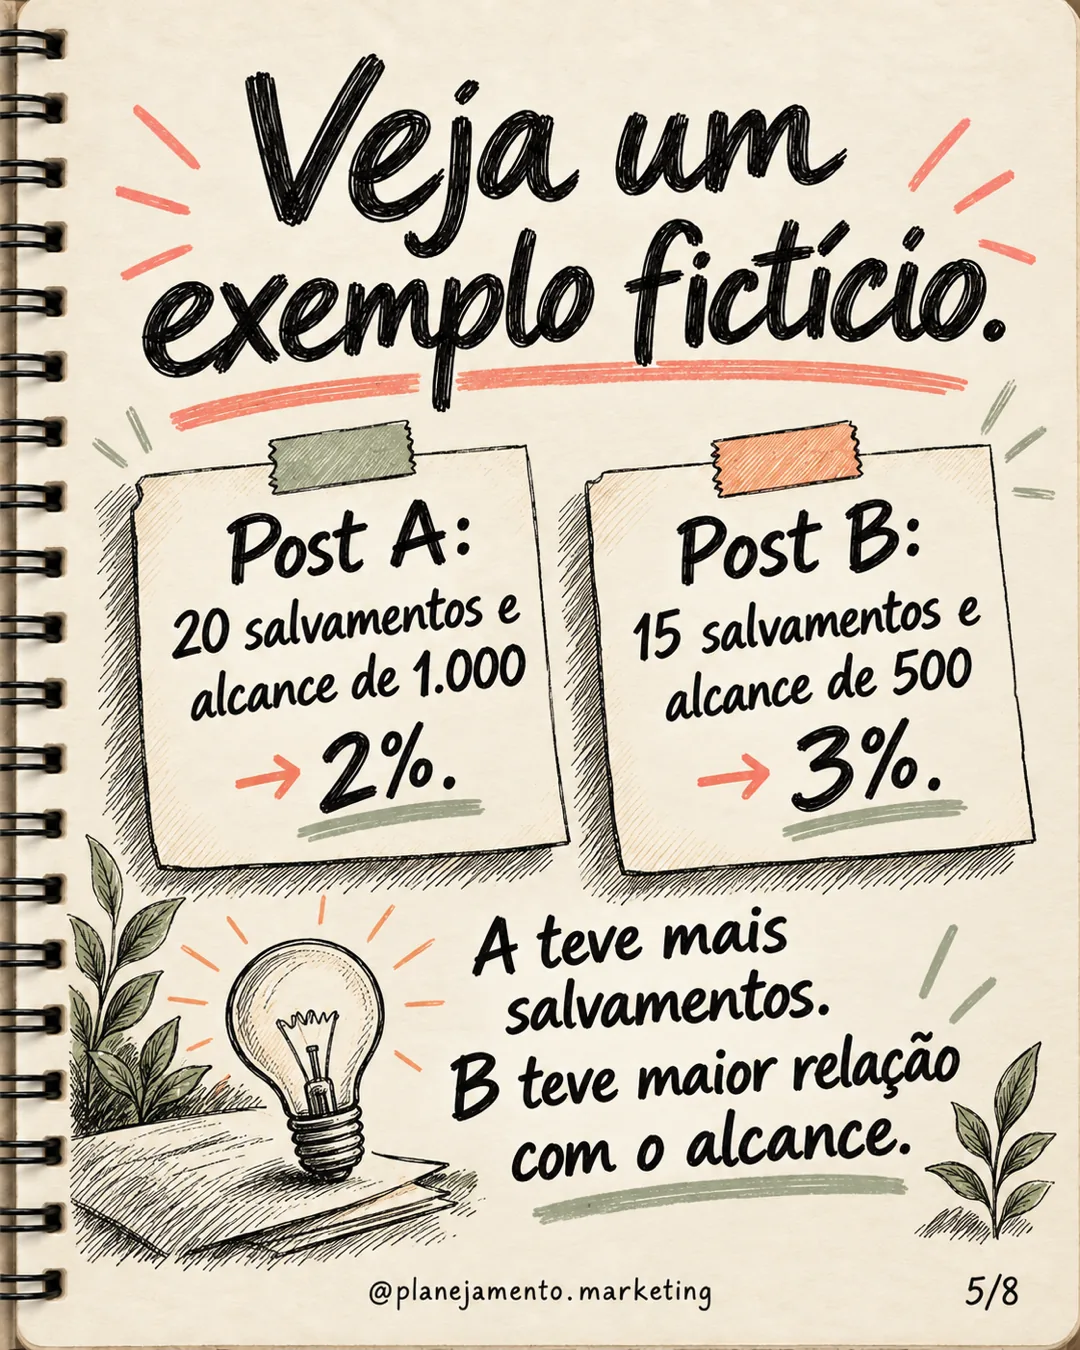
Um perfil fictício publica dois carrosséis sem mídia paga, e lê ambos no sétimo dia:
| Post | Salvamentos | Alcance | Taxa de salvamento |
|---|---|---|---|
| A | 20 | 1.000 | 2,0% |
| B | 15 | 500 | 3,0% |
O post B tem a razão maior, mas o post A teve mais ocorrências de salvamento. Nenhuma dessas medidas, sozinha, define o melhor conteúdo. A razão descreve ocorrências por alcance estimado; a contagem registra o total de ações, não necessariamente o número de pessoas distintas que agiram.
Há ainda a incerteza, mas não devemos criar uma precisão estatística que os dados não sustentam. Brown, Cai e DasGupta estudam intervalos para proporções binomiais: resultados com estrutura de sucesso ou insucesso em um número definido de tentativas. Aqui temos contagens de ações e alcance estimado, sem dados individuais que confirmem essa estrutura. Por isso, não aplicamos um intervalo binomial aos dois posts nem declaramos um vencedor estatístico. A diferença descritiva de 1 ponto percentual é um sinal para investigar, não uma prova.
E mesmo que a diferença fosse nítida, não provaria causalidade. B pode ter ido melhor por causa do tema, do horário, do público que o algoritmo escolheu, ou de uma combinação disso. Cada um dos 20 e 15 salvamentos tem uma história que a planilha não registra.
Três armadilhas de interpretação
Escolher os “campeões” e esperar que se repitam. Se você seleciona os posts de maior taxa e depois mede o seguinte, é comum o seguinte parecer pior sem que nada tenha mudado. Barnett, van der Pols e Dobson descrevem esse fenômeno, a regressão à média: a variação natural dos dados parece mudança real quando se parte de valores extremos selecionados. Um post excepcional em parte foi excepcional por sorte, e a sorte não se repete por encomenda.
Transformar associação em efeito do conteúdo. Gordon e colaboradores compararam estimativas observacionais de publicidade no Facebook com experimentos randomizados e encontraram diferenças importantes entre os métodos. Lewis, Rao e Reiley discutem o viés de atividade: pessoas mais ativas online podem também comprar mais, independentemente da publicidade. São estudos de anúncios pagos, não de posts orgânicos. Eles ajudam a formular um cuidado por analogia: quem recebeu ou salvou um post pode já ter interesse maior no tema; o painel não isola o efeito da peça.
Otimizar o indicador em vez do objetivo. Manheim e Garrabrant listam variantes da lei de Goodhart, entre elas a regressional, na qual selecionar para um indicador imperfeito também seleciona o erro dele. Se você passar a escolher temas só pela taxa de salvamento, tende a favorecer conteúdos fáceis de salvar (listas, checklists), que podem não ser os que aproximam o leitor do que você oferece.
Comentários e o público que você não vê
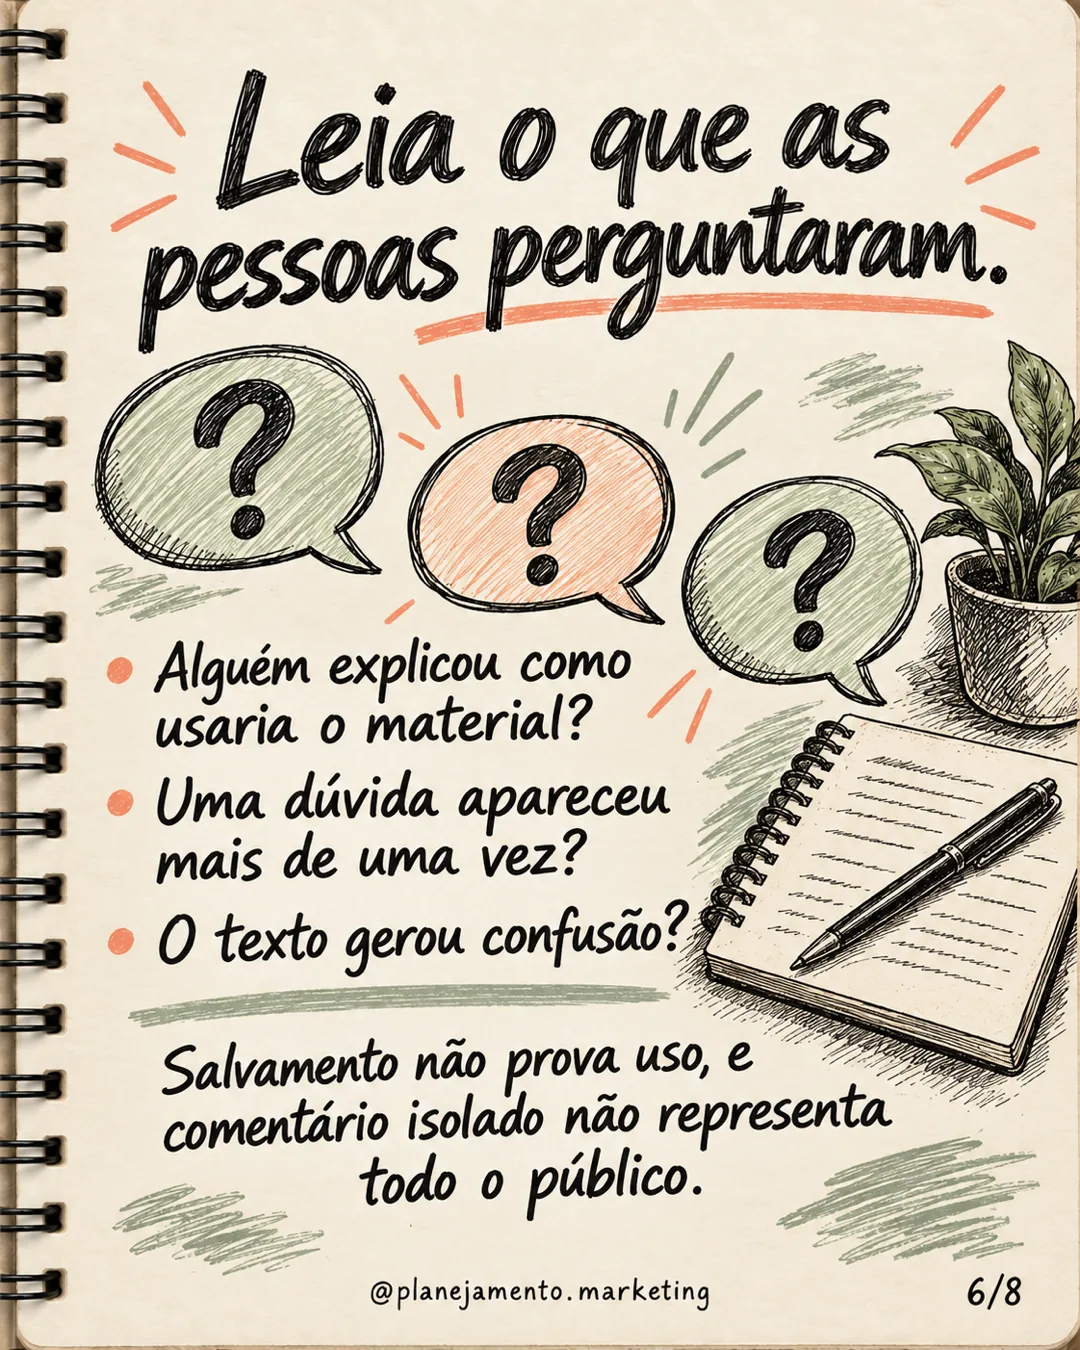
Comentários são úteis para entender dúvidas e vocabulário, mas não representam o público inteiro. Em outro contexto (usuários do Twitter), o Pew Research Center mostrou que os 10% mais ativos em volume de tweets diferem dos usuários que escrevem pouco em características que vão além da quantidade de conteúdo. É uma analogia, não um dado sobre Instagram: quem comenta tende a ser um subgrupo mais ativo do que quem apenas vê. Use comentários para gerar hipóteses, e não para medir o que o público como um todo pensa.
Do registro a um próximo teste
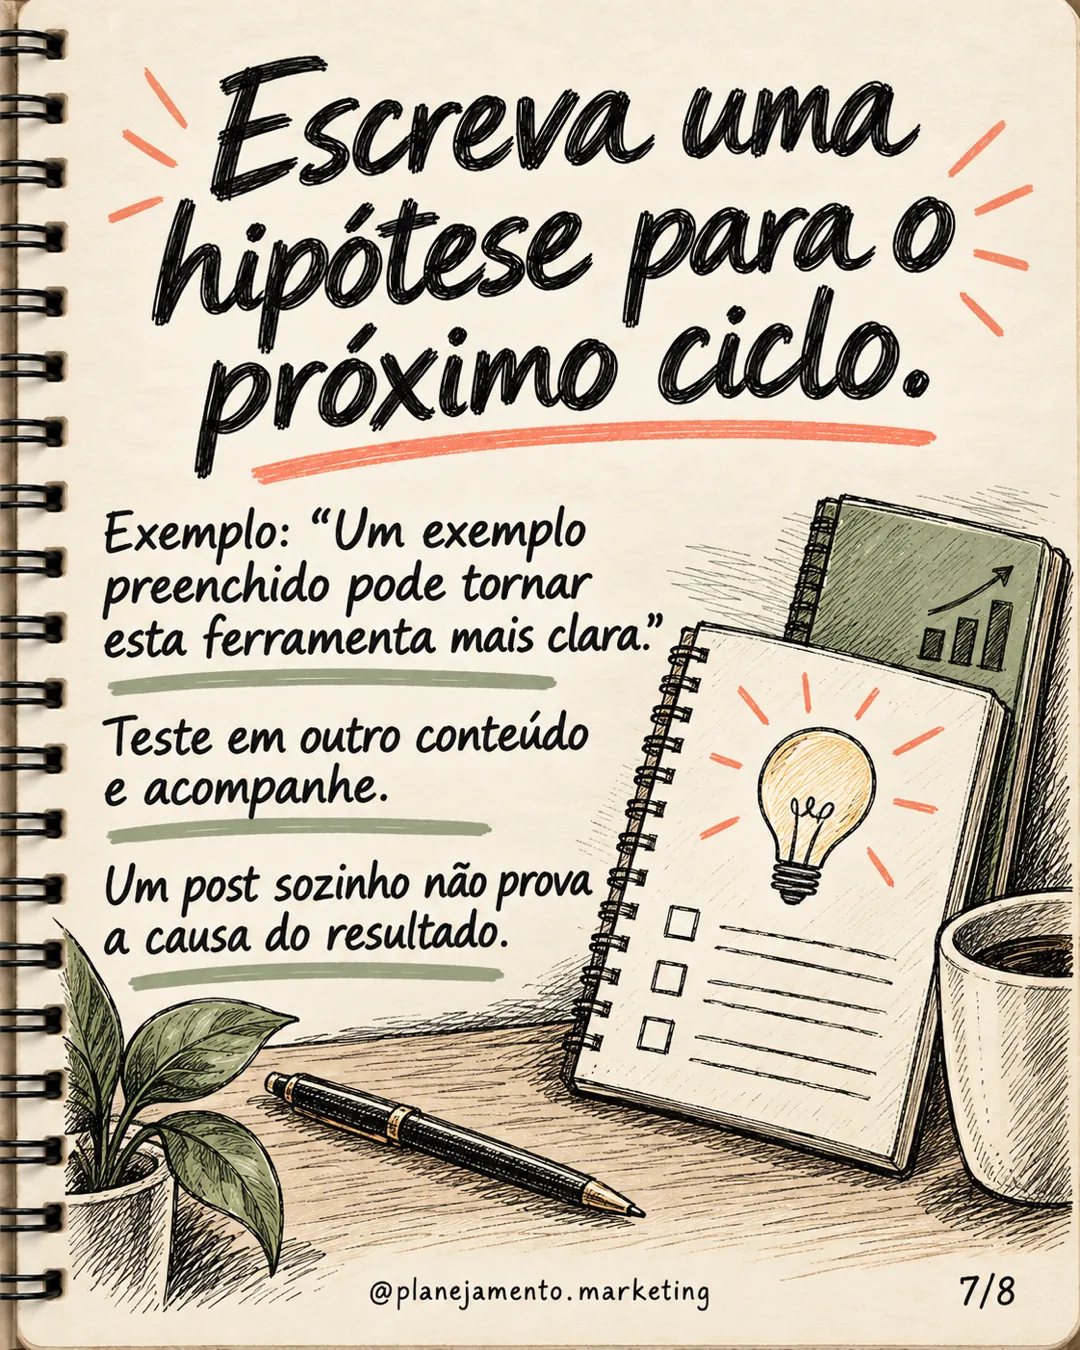
A análise só vira aprendizagem quando termina em uma hipótese que possa ser desmentida. Um modelo de formulação:
> Se publicarmos [formato] sobre [tema] com a promessa [X] e o CTA [Y], para o público [Z], esperamos taxa de salvamento maior que em [comparação], medida em 7 dias, sem mídia paga.
Pontos para fechar antes de publicar:
- Uma variável muda por vez. Se mudar tema e formato juntos, você não saberá qual fez diferença.
- A comparação já está definida. Por exemplo, os últimos cinco carrosséis sem mídia paga.
- O critério de decisão está escrito. Qual diferença faria você mudar a rotina de produção, e qual não faria.
- Você aceita não concluir. Kohavi e colaboradores descrevem experimentos controlados como o desenho mais sólido para estabelecer relação causal. Em um perfil, você raramente consegue randomização verdadeira, e deve tratar os resultados do seu teste como indício, e não como prova.
Não use dados de fechamento do mês corrente antes de ele terminar. Faça a leitura dos posts com janela já completa e revise a hipótese depois.
Quando o objetivo também envolver visitas ao blog, use links identificados conforme o guia de URLs de campanha do Google Analytics. Mantenha origem, meio e campanha consistentes, sem dados pessoais nos parâmetros. Isso ajuda a organizar os cliques que chegam ao site; não mede quem apenas leu o Instagram nem prova uma relação causal com vendas. Para conectar a revisão à operação comercial, veja também marketing como motor de receita.
Limites do método
- O alcance é estimado e a coleta pode ter atraso.
- Poucos posts por categoria limitam as comparações. Não existe um corte universal que transforme uma coleção de posts em evidência conclusiva.
- A ficha de codificação depende de julgamento humano; sem verificar a consistência, você mede sua própria variação de critério.
- Observação não é experimento. Tema, formato e horário variam juntos na vida real.
- Saves e compartilhamentos não medem vendas, leads nem uso do conteúdo.
Perguntas frequentes
Posso usar o percentual de salvamentos como “percentual de pessoas que salvaram”? Não. É a razão entre ocorrências de salvamento e contas alcançadas (estimadas). Descreva como “salvamentos por 100 contas alcançadas”.
O que fazer quando o alcance de um post é zero ou vem vazio? Não calcule a razão e marque como “sem dado” ou “alcance zero”, conforme o caso. Dado vazio e zero medido são situações diferentes.
Por que 7 dias? É um exemplo de janela comum, e o importante é ser igual para todos os posts. Se o seu conteúdo circula por mais tempo, use 14 dias, mas mantenha constante.
Posso incluir posts impulsionados? Analise-os em separado. Interações pagas e orgânicas não respondem à mesma pergunta.
Quantos posts preciso para tirar conclusões? Não há número mágico. Quanto menos posts por categoria, mais largo o intervalo de incerteza. Trate poucos posts como material para hipótese.
O volume de busca de um tema me diz o que vai funcionar no Instagram? Não. Volume de busca indica interesse na busca, e não garante desempenho de um post nem substitui o seu próprio registro.
Referências internacionais
- Meta. Instagram Platform: IG Media Insights, referência de métricas (alcance, salvamentos, compartilhamentos, total de interações). Documentação oficial para desenvolvedores, Meta Platforms.
- Brown, L. D.; Cai, T. T.; DasGupta, A. (2001). Interval Estimation for a Binomial Proportion. Statistical Science, 16(2).
- Gordon, B. R.; Zettelmeyer, F.; Bhargava, N.; Chapsky, D. A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook. Kellogg School of Management, Northwestern University.
- Hallgren, K. A. (2012). Computing Inter-Rater Reliability for Observational Data: An Overview and Tutorial. Tutorials in Quantitative Methods for Psychology, 8(1).
- Kohavi, R.; Longbotham, R.; Sommerfield, D.; Henne, R. M. (2009). Controlled experiments on the web: survey and practical guide. Data Mining and Knowledge Discovery, 18.